Oltre il Silicio: Come l'Ottimizzazione Logica di Gemma 4 Ridefinisce la Lotta per l'Efficienza dell'IA
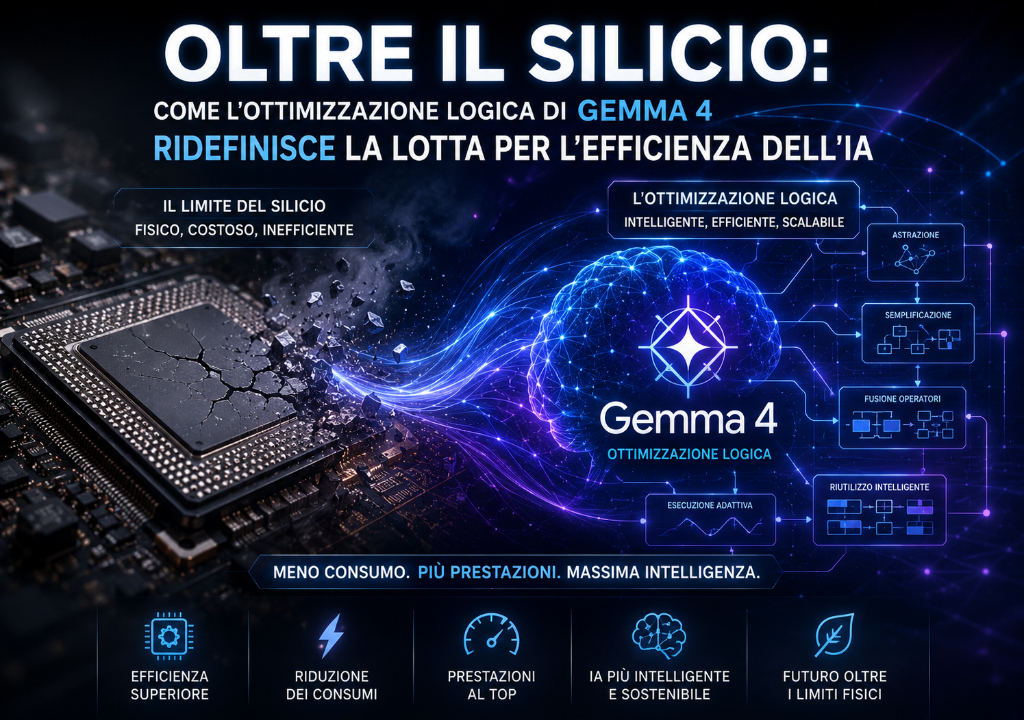
Per anni, la narrazione dominante nel settore dell' è stata focalizzata su una singola variabile: la potenza bruta. Più GPU, più VRAM, chip più densi e cluster di calcolo sempre più mastodontici sembravano essere l'unica via per superare i limiti della latenza e aumentare le prestazioni dei Large Language Models (LLM). Tuttavia, l'introduzione deiMulti-Token Prediction (MTP) draftersper la famiglia di modelliGemma 4di Google segna un cambio di paradigma fondamentale. Non si tratta più solo di quanto hardware si possiede, ma di come il software gestisce l'intelligenza.
L'innovazione introdotta da Google non agisce sulla struttura fisica dei chip, ma sulla logica stessa della generazione del testo. Attraverso una tecnica sofisticata nota comespeculative decoding, Gemma 4 dimostra che l'efficienza software può colmare il divario tra le workstation professionali e l'hardware consumer, ridefinendo i termini della competizione tra i giganti dell'IA.
Il Collo di Bottiglia dell'Inferenza: Perché l'Hardware da Solo non Basta
Per comprendere la portata della novità di Gemma 4, è necessario analizzare il problema strutturale dei modelli autoregressivi. Tradizionalmente, un LLM genera testo un singolo token alla volta. Questo processo, sebbene efficace per la coerenza linguistica, crea un collo di bottiglia critico legato alla larghezza di banda della memoria (memory-bandwidth bound).
In termini tecnici, per ogni singolo frammento di parola prodotto, il processore deve spostare miliardi di parametri dalla memoria VRAM alle unità di calcolo. Questo significa che, anche disponendo di una GPU estremamente potente, gran parte della capacità di calcolo rimane inutilizzata mentre il sistema attende che i dati vengano trasferiti. Il risultato è una latenza percepibile, specialmente su hardware consumer, dove la velocità di trasferimento della memoria è significativamente inferiore rispetto ai sistemi server di fascia alta.
Fino a oggi, la soluzione standard per mitigare questo problema era la compressione dei modelli o l'utilizzo di versioni più piccole, con il rischio però di degradare le capacità di ragionamento e la qualità dell'output. Google ha scelto una strada diversa: mantenere l'integrità del modello principale, ottimizzando il flusso logico della generazione.
Lo Speculative Decoding: L'Architettura del "Predittore e Verificatore"
Il cuore della strategia di Gemma 4 risiede nell'implementazione deiMTP drafters. Il concetto dispeculative decoding, esplorato da Google già dal 2022, introduce un sistema a due livelli che separa la generazione dalla verifica.
Il Ruolo del Drafter (Il Predittore)
Il "drafter" è un modello estremamente leggero e veloce, progettato per agire come un assistente rapido. Invece di attendere che il modello principale elabori ogni singolo token, il drafter ipotizza una sequenza di più token contemporaneamente. Poiché è molto più piccolo, può fare queste previsioni in una frazione del tempo necessario al modello target.
Il Ruolo del Modello Target (Il Verificatore)
Il modello principale (ad esempio, Gemma 4 31B) interviene successivamente. Invece di generare i token uno a uno, riceve l'intera sequenza proposta dal drafter e la convalida in un unico passaggio parallelo. Se le previsioni del drafter sono corrette, l'intera stringa viene accettata istantaneamente.
Questo processo trasforma i "tempi morti" dell'inferenza tradizionale in cicli di calcolo produttivi. Se il modello target concorda con il draft, può persino generare un token aggiuntivo durante la fase di convalida, massimizzando l'efficienza temporale. Se invece il drafter commette un errore, il modello target corregge il token errato e il processo di predizione riparte da quel punto, garantendo che nessun ciclo di calcolo venga sprecato.
Risultati Concreti: L'Impatto su Hardware Diversificato
L'efficacia di questo approccio non è solo teorica, ma si traduce in incrementi prestazionali tangibili su diverse architetture, rendendo modelli complessi improvvisamente fluidi su macchine locali.
Hardware | Modello | Incremento Velocità (Speed-up) |
|---|---|---|
NVIDIA RTX Pro 6000 | Gemma 4 26B | Raddoppio dei token/s (2x) |
Apple Silicon | Gemma 4 (Batch 4-8) | Incremento di circa 2.2x |
Scenario Ottimale | Generale | Fino a 3x rispetto agli standard |
Questi dati evidenziano come l'ottimizzazione logica permetta di superare i limiti fisici dell'hardware. Un incremento di 2.2x su Apple Silicon o il raddoppio delle prestazioni su GPU NVIDIA professionali significa che modelli precedentemente considerati "al limite" per l'uso locale diventano ora strumenti pronti per flussi di lavoro professionali, come l'assistenza al coding in tempo reale o la gestione di agenti autonomi.
Sinergia Tecnica: La Gestione della KV Cache
Per rendere il sistema davvero efficiente, Google non si è limitata allo speculative decoding, ma ha implementato una gestione condivisa dellaKV cache (Key-Value cache). In un sistema di inferenza standard, il ricalcolo del contesto per ogni nuovo token è un'operazione costosa in termini di risorse.
Permettendo al drafter e al modello principale di condividere la cache dei valori e delle chiavi, Google evita che il modello leggero debba ricalcolare contesti già elaborati dal modello target. Questa ottimizzazione riduce ulteriormente l'overhead computazionale, rendendo il passaggio tra predizione e verifica quasi istantaneo e preservando, nei dispositivi edge, la durata della batteria.
L'Impatto Strategico: Software vs Hardware
L'introduzione dei drafter MTP in Gemma 4 si inserisce in un contesto geopolitico e industriale più ampio. Per anni, il mercato dell'IA è stato dominato dalla corsa all'hardware, con un vantaggio competitivo enorme per chi controllava la produzione di silicio. Tuttavia, l'esempio recente di aziende come DeepSeek ha dimostrato che l'ottimizzazione dei costi di addestramento e inferenza può scuotere le valutazioni di mercato dei giganti del silicio.
Spostando l'attenzione dalla "potenza bruta" all' "efficienza logica", Google persegue due obiettivi strategici:
- Democratizzazione dell'IA Locale:Rendendo i modelli 26B e 31B utilizzabili su PC consumer, Google spinge l'adozione dell'IA on-device, riducendo la dipendenza dal cloud e migliorando la privacy e la latenza.
- Efficienza Operativa:L'ottimizzazione del serving riduce i costi computazionali per le aziende che implementano questi modelli in produzione, rendendo l'IA più sostenibile e scalabile.
Questo approccio è particolarmente critico per lo sviluppo diagenti autonomieinterfacce vocali, dove ogni millisecondo di latenza può compromettere l'esperienza utente o l'efficacia del ragionamento multi-step.
Accessibilità e Integrazione nell'Ecosistema Open Source
Per garantire che questa innovazione non rimanga confinata nei laboratori di Mountain View, Google ha distribuito i nuovi drafter sottolicenza Apache 2.0. La scelta di renderli disponibili tramite i principali repository del settore sottolinea la volontà di alimentare l'ecosistema open source.
I drafter MTP sono ora accessibili su:
- Hugging Face:Il punto di riferimento per la community dei modelli pre-addestrati.
- Kaggle:Per i data scientist e i ricercatori.
- :Per chi desidera eseguire modelli localmente con facilità.
Inoltre, il supporto nativo per framework comevLLM, MLX, SGLange la libreriaTransformersdi Hugging Face assicura che gli sviluppatori possano integrare queste velocità superiori nei propri applicativi senza dover riscrivere l'intera infrastruttura di serving.
Conclusioni: Verso un'Intelligenza più Agile
L'evoluzione di Gemma 4 con i Multi-Token Prediction drafters dimostra che la strada verso l'IA di frontiera non passa necessariamente per l'aggiunta di miliardi di parametri o per l'acquisto di hardware sempre più costoso. La vera sfida si è spostata verso l'ottimizzazione del modo in cui l'informazione fluisce tra la memoria e l'unità di calcolo.
Senza compromettere la qualità dell'output o le capacità di ragionamento, Google ha dimostrato che è possibile triplicare la velocità di generazione attraverso l'intelligenza architettonica. In un mondo dove la latenza è il principale ostacolo all'integrazione dell'IA nella vita quotidiana, l'efficienza software sta diventando l'arma più potente per ridefinire il futuro del calcolo cognitivo.
Potrebbero interessarti
Smartwatch a confronto: Apple Watch Series 9 vs Galaxy Watch 6
Guida ai migliori smartwatch per il fitness 2025: Apple Watch Series 9 vs Galaxy ...
Leggi ->Come integrare Alexa con dispositivi non compatibili tramite IFTTT
Amazon Alexa è diventata la smart speaker di riferimento per molte case moderne, ...
Leggi ->Assistenti Vocali Offline vs. Cloud: Pro e Contro per la Privacy e l'Affidabilità
Nel giro di un decennio, gli assistenti vocali sono passati dall'essere una curiosità t ...
Leggi ->Il Segreto per il Mutuo Perfetto nel 2025: tassi al 2,25%, Bonus Prima Casa e Domanda in 5 Minuti!
Nel 2025 richiedere un mutuo in Italia non è mai stato così semplice e convenient ...
Leggi ->Rinnovabili record: coprono il 56% della domanda in Italia
Un nuovo traguardo per l'energia pulitaNel primo semest ...
Leggi ->Il Saldatore a Pistola: Guida Completa per Saldature Efficienti e Professionali
In questo articolo, esploreremo a fondo le caratteristiche, le tecniche e i segre ...
Leggi ->Rivoluzione Energetica: Liberati dalle Bollette Salate e Vivi in una Casa 100% Green
Sei stufo di vedere le tue bollette energetiche lievitare mese dopo mese? Ti sent ...
Leggi ->Recensione ZeroClaw: Test di performance e benchmark aggiornati
Nel panorama dell' AI e dell'orchestrazione di agenti, l'efficienza delle risorse è div ...
Leggi ->