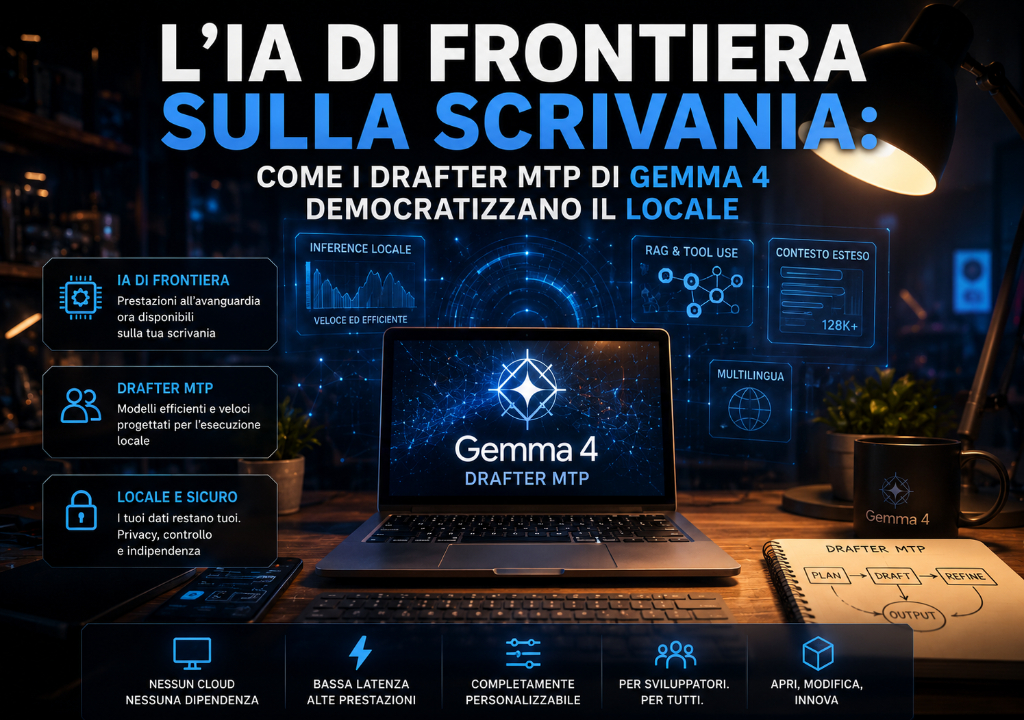
L'IA di Frontiera sulla Scrivania: Come i Drafter MTP di Gemma 4 Democratizzano l' Locale
Per anni, l'utilizzo di modelli linguistici di grandi dimensioni (LLM) ad alte prestazioni è stato appannaggio di chi possedeva infrastrutture cloud massicce o workstation professionali da decine di migliaia di euro. Per l'utente comune, l'esperienza di eseguire un modello "denso" e potente sul proprio PC era spesso frustrante: una generazione di testo lenta, a scatti, dove ogni parola appariva sullo schermo con un ritardo percepibile. Questa barriera non era dovuta a una mancanza di potenza di calcolo bruta, ma a un collo di bottiglia architettonico intrinseco al modo in cui i transformer elaborano le informazioni.
L'introduzione deiMulti-Token Prediction (MTP) draftersper la famigliaGemma 4di Google segna un punto di svolta fondamentale. Non si tratta di un semplice aggiornamento incrementale, ma di una strategia di ottimizzazione che rende modelli complessi, come la versione da 26B, fluidi e realmente utilizzabili su hardware consumer. Questa evoluzione apre la strada a una vera democratizzazione dell'IA locale, spostando il baricentro della potenza computazionale dal cloud direttamente sul dispositivo dell'utente.
Il Collo di Bottiglia della Memoria: Perché l'IA Locale era Lenta
Per comprendere l'impatto dei drafter MTP, è necessario analizzare il problema tecnico che Google ha voluto risolvere. I Large Language Models tradizionali operano in modoautoregressivo: generano un singolo token (un frammento di parola) alla volta. Ogni volta che il modello deve produrre il token successivo, l'intero sistema deve spostare miliardi di parametri dalla memoria video (VRAM) alle unità di calcolo della GPU.
Questo processo crea un fenomeno noto comememory-bandwidth bound. In termini semplici, il processore passa la maggior parte del suo tempo ad aspettare che i dati arrivino dalla memoria, lasciando le unità di calcolo sottoutilizzate. È un paradosso: l'hardware ha la potenza per fare calcoli complessi, ma viene frenato dalla velocità di trasferimento dei dati. Per l'utente finale, questo si traduce in una latenza elevata, rendendo i modelli più grandi (e quindi più intelligenti) quasi impraticabili per applicazioni in tempo reale come l'assistenza al coding o le interfacce vocali.
La Soluzione: Lo Speculative Decoding e i Drafter MTP
Google ha affrontato questo problema implementando una tecnica chiamataspeculative decoding, portata ai massimi livelli di efficienza attraverso l'architettura MTP. Invece di affidarsi esclusivamente al modello principale (il "target model"), che è potente ma lento, il sistema introduce undrafter: un modello estremamente leggero e veloce che agisce come un predittore.
Come funziona il processo di generazione "speculativa"
- La Fase di Bozza (Drafting):Il drafter MTP ipotizza rapidamente una sequenza di più token futuri. Poiché è molto piccolo, può generare queste ipotesi in una frazione del tempo che il modello principale impiegherebbe per produrre un singolo token.
- La Fase di Validazione (Verification):Il modello principale, invece di generare un token da zero, riceve l'intera sequenza proposta dal drafter e la verifica in un unico passaggio parallelo.
- L'Accettazione o Correzione:Se il modello principale concorda con le previsioni del drafter, l'intera stringa di token viene accettata istantaneamente. Se invece rileva un errore, corregge il token errato e il drafter ricomincia la sua predizione a partire dal punto corretto.
Il vantaggio cruciale è che, durante la fase di validazione, il modello principale può persino generare un token aggiuntivo proprio mentre verifica la bozza. Questo significa che l'applicazione può produrre una sequenza completa di token nel tempo in cui, precedentemente, ne produceva solo uno.
Risultati Concreti: Performance su Hardware Consumer
L'impatto di questa tecnologia non è solo teorico, ma si traduce in incrementi di velocità tangibili su diverse architetture hardware, rendendo i modelli densi di Gemma 4 estremamente reattivi.
Hardware | Modello | Incremento Velocità (Speedup) | Impatto Esperienziale |
|---|---|---|---|
NVIDIA RTX Pro 6000 | Gemma 4 26B | 2x (Raddoppio token/s) | Fluidità professionale, ideale per workflow complessi. |
Apple Silicon | Gemma 4 (vari versioni) | ~2.2x (con batch size 4-8) | Ottimizzazione per Mac, riduzione drastica della latenza. |
Hardware Consumer Generico | Gemma 4 Family | Fino a 3x (Teorico) | Trasformazione di modelli "al limite" in strumenti fluidi. |
È importante sottolineare che questo boost prestazionale avvienesenza alcuna degradazione della qualità dell'output. Poiché il modello principale mantiene l'ultima parola sulla validazione di ogni token, le capacità di ragionamento e l'accuratezza rimangono identiche a quelle del modello originale. Non si tratta di una compressione o di una quantizzazione aggressiva che sacrifica l'intelligenza, ma di un'ottimizzazione logica della gestione dei carichi di lavoro.
Ottimizzazioni Tecniche Avanzate: La KV Cache Condivisa
Per massimizzare l'efficienza, Google non si è limitata allo speculative decoding, ma ha implementato una gestione condivisa dellaKV cache (Key-Value cache). In un sistema di inferenza standard, il calcolo del contesto (la memoria di ciò che è stato detto in precedenza nella conversazione) può essere ridondante.
Grazie alla cache condivisa, il drafter non deve ricalcolare i contesti che sono già stati elaborati dal modello principale. Questo riduce ulteriormente l'overhead computazionale e libera risorse preziose, permettendo al sistema di concentrarsi esclusivamente sulla generazione di nuovi token. Questa sinergia tra architettura MTP e gestione della memoria è ciò che permette a Gemma 4 di correre in modo così efficiente su dispositivi con risorse limitate.
L'Impatto Strategico: Verso un'IA Locale e Open Source
La mossa di Google si inserisce in un contesto di mercato dove l'efficienza software sta diventando competitiva quanto la potenza hardware. La capacità di far girare modelli densi (come quelli da 26B o 31B) su PC consumer ha implicazioni profonde per diversi settori:
- Sviluppo Software:Gli assistenti al coding locali possono ora fornire suggerimenti in tempo reale senza i ritardi che rendono l'esperienza frustrante, migliorando la produttività dei programmatori che preferiscono mantenere il codice offline per motivi di privacy.
- Agenti Autonomi:Gli agenti che richiedono una pianificazione multi-step rapida beneficiano enormemente della riduzione della latenza, potendo elaborare catene di pensiero più velocemente.
- Dispositivi Edge e Mobile:L'applicazione di queste tecniche ai modelli più piccoli (come E2B e E4B) non solo accelera le risposte, ma preserva la durata della batteria, riducendo il tempo di attività intensiva della GPU/NPU.
- Privacy e Sicurezza:Rendendo i modelli potenti "fluidi" localmente, si riduce la dipendenza dai servizi cloud, permettendo alle aziende e agli utenti di processare dati sensibili senza che questi lascino mai il proprio hardware.
Accessibilità e Integrazione nell'Ecosistema
Per garantire che questa innovazione non rimanesse confinata ai laboratori di ricerca, Google ha adottato una strategia di distribuzione aperta. I drafter MTP sono stati rilasciati sottolicenza Apache 2.0e sono già disponibili sui principali repository utilizzati dalla comunità globale di sviluppatori:
- Hugging Face:Per l'integrazione immediata tramite la libreriaTransformers.
- Kaggle:Per l'analisi dei dati e la sperimentazione.
- :Per chi desidera eseguire modelli locali con una configurazione semplificata.
Inoltre, il supporto nativo per framework comevLLM, MLX, SGLangassicura che chiunque stia già implementando Gemma 4 in ambienti cloud ottimizzati o su hardware Apple possa attivare queste funzionalità con modifiche minime al proprio stack tecnologico.
Conclusioni: Il Futuro dell'Inferenza
L'introduzione dei drafter MTP in Gemma 4 dimostra che la strada per un' più accessibile non passa necessariamente per la creazione di modelli sempre più piccoli e semplificati, ma per l'implementazione di metodi di inferenza più intelligenti. Superando il limite della generazione di un singolo token alla volta, Google ha rimosso uno dei principali ostacoli psicologici e tecnici all'adozione dell'IA locale.
Siamo entrati in un'era in cui la fluidità di un'interfaccia IA non dipende più solo dalla larghezza di banda della connessione internet o dal costo del canone mensile di un servizio cloud, ma dall'efficienza con cui il software orchestra le risorse del proprio PC. Con Gemma 4, l'IA di frontiera non è più un servizio remoto, ma un componente integrato, rapido e privato, pronto per essere integrato in ogni flusso di lavoro professionale.
Potrebbero interessarti
Il Saldatore a Pistola: Guida Completa per Saldature Efficienti e Professionali
In questo articolo, esploreremo a fondo le caratteristiche, le tecniche e i segre ...
Leggi ->I vantaggi delle pompe di calore rispetto ai sistemi a gas
Ciao e bentornati! In questo articolo, voglio parlare di uno dei temi più discuss ...
Leggi ->Strumenti open source per creare un monitoraggio rete professionale senza spendere
Il monitoraggio della rete è una delle attività più critiche per garantire la continuit ...
Leggi ->Come si legge un condensatore
Un condensatore è un componente elettronico che immagazzina energia sotto forma d ...
Leggi ->Linee di Sicurezza (Safety PLC): Una Guida introduttiva
I controllori logici programmabili (PLC) sono ...
Leggi ->Come scegliere il proprio impianto solare BASE
La transizione energetica è ormai una priorità nazionale e la produzione di energ ...
Leggi ->Installare un impianto fotovoltaico con accumulo a casa: 7 passi dalla valutazione del tetto alla certificazione
Installare un impianto fotovoltaico ...
Leggi ->Manutenzione delle Stampa 3D: guida pratica
La stampa 3D è una tecnologia in continua evoluzione che consente a professionist ...
Leggi ->