Una scheda, 700 miliardi di parametri e consuma meno della metà di NVIDIA Blackwell
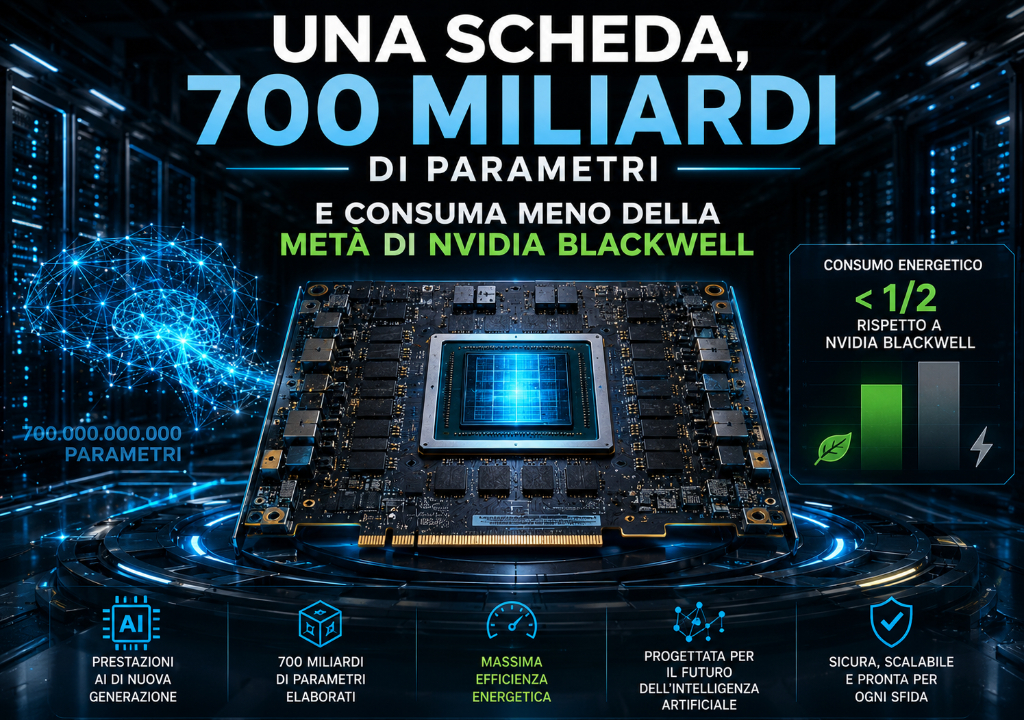
Il panorama dell' locale sta attraversando una fase di profonda trasformazione. Mentre l'industria si è tradizionalmente affidata a cluster massivi di GPU o a costose infrastrutture cloud, l'azienda taiwanese Skymizer ha presentato una soluzione che punta a scardinare questo paradigma: l'HTX301. Si tratta di un acceleratore PCIe progettato specificamente per l'inferenza di Large Language Model (LLM), capace di gestire modelli fino a 700 miliardi di parametri su una singola scheda, mantenendo un profilo energetico estremamente contenuto.
L'obiettivo di questo hardware non è sostituire le GPU general-purpose in ogni ambito, ma offrire un'alternativa efficiente per le aziende che necessitano di eseguire modelli complessi on-premise, riducendo i costi operativi e l'impatto ambientale.
L'Architettura HyperThought e l'introduzione della LPU
Il cuore tecnologico dell'HTX301 è la piattaforma HyperThought, che introduce il concetto di LPU (Language Processing Unit). A differenza delle GPU tradizionali, progettate per calcoli paralleli generici (grafica, rendering, calcolo scientifico), la LPU è un'architettura nata espressamente per i carichi di lavoro degli LLM.
Ottimizzazione del flusso di lavoro: Prefill e Decode
Una delle innovazioni principali di HyperThought risiede nella gestione separata e coordinata delle due fasi critiche dell'inferenza AI:
- Prefill: La fase iniziale in cui il modello elabora l'input dell'utente.
- Decode: La fase di generazione successiva dei token.
Questa specializzazione permette di ottimizzare l'efficienza energetica e di aumentare la velocità di risposta, evitando i colli di bottiglia tipici delle architetture non dedicate.
Specifiche Tecniche e Performance
Nonostante l'utilizzo di un processo produttivo a 28 nm — meno avanzato rispetto ai nodi nanometrici utilizzati dai principali competitor — l'HTX301 riesce a dichiarare numeri di rilievo grazie a un design focalizzato sull'efficienza del dato.
Capacità di Memoria e Scalabilità
L'HTX301 adotta un design PCIe tradizionale con memoria distribuita attorno ai processori. La scelta strategica di Skymizer è stata quella di utilizzare memorie LPDDR4 e LPDDR5 invece di HBM o GDDR6/7. Questa decisione permette di:
- Raggiungere una capacità di memoria fino a 384 GB.
- Ridurre drasticamente i costi di produzione e di acquisizione per l'utente finale.
- Mantenere un equilibrio sostenibile tra larghezza di banda e capacità di storage per i pesi del modello.
Dati di Performance
L'architettura Octa-Core LPU offre prestazioni concrete, specialmente in scenari di scalabilità:
Parametro | Valore / Prestazione |
|---|---|
Token al secondo (standard) | 30 token/s con 0,5 TOPS e banda 100 GB/s |
Prefill Llama2 7B (Octa-Core) | 240 token/s |
Scalabilità multi-chip | Fino a 1200 token/s |
Capacità massima parametri | 700 miliardi |
Efficienza Energetica: Il confronto con NVIDIA Blackwell
Il punto di maggior rottura rispetto agli standard di mercato è il consumo energetico. Il TDP (Thermal Design Power) dell'HTX301 è di 240W.
Per contestualizzare questo dato, è utile confrontarlo con gli acceleratori PCIe AI di fascia alta:
- NVIDIA RTX PRO 6000 Blackwell: 600W
- AMD Instinct MI350P: 600W
L'HTX301 consuma quindi meno della metà rispetto a queste soluzioni. Per un'azienda che implementa l'AI su larga scala, questo si traduce in una riduzione netta dei costi di elettricità e in requisiti di raffreddamento meno onerosi, rendendo l'inferenza locale molto più sostenibile.
- Costi: L'uso di LPDDR4/5 abbassa il prezzo rispetto a HBM.
- Energia: TDP di 240W contro i 600W della concorrenza high-end.
- Capacità: Supporto fino a 700 miliardi di parametri su una singola scheda.
- Focus: Architettura LPU dedicata esclusivamente al linguaggio.
Tecnologie di Compressione Avanzate
Per rendere possibile l'esecuzione di modelli così imponenti su hardware locale, Skymizer ha implementato tecnologie di compressione proprietarie che superano le soluzioni open-source più diffuse.
Compressione dei Pesi e Cache KV
L'efficacia di queste tecniche è misurata in termini di precisione e perdita di informazioni:
- Compressione del "Peso" (Memoria a lungo termine): Risulterebbe superiore a .cpp con un miglioramento che oscilla tra il 9% e il 17,8%.
- Compressione della cache KV: La perdita di perplessità (ovvero quanto il modello diventa "meno preciso") è estremamente contenuta, attestandosi tra lo 0,06% e il 3,52%.
Impatto per il mercato Enterprise e le PMI
L'introduzione di una scheda come l'HTX301 ha implicazioni dirette per diverse categorie di utenti professionali, specialmente in contesti dove la sovranità del dato e l'efficienza energetica sono prioritarie.
Vantaggi per le aziende
- Riduzione della dipendenza dal Cloud: La possibilità di far girare modelli da 700 miliardi di parametri on-premise elimina i costi di abbonamento ricorrenti e i rischi legati alla privacy dei dati.
- Sostenibilità economica: Per le piccole e medie imprese, l'abbattimento dei consumi energetici permette di integrare l'AI senza far lievitare eccessivamente le spese fisse.
- Applicazioni verticali: Settori come la finanza, la sanità e il marketing possono implementare analisi predittive e personalizzazioni avanzate mantenendo l'intera infrastruttura all'interno dei propri sistemi.
Conclusioni
L'HTX301 di Skymizer si presenta come un progetto estremamente ambizioso che sfida la logica della "forza bruta" (più transistor, più watt) a favore di un'architettura specializzata. Se le prestazioni dichiarate troveranno conferma nei test reali, potremmo assistere alla nascita di una nuova categoria di acceleratori: le LPU, capaci di democratizzare l'accesso ai modelli di linguaggio più grandi del mondo senza richiedere l'energia di un piccolo data center.
L'attesa ora è rivolta alle dimostrazioni pratiche, dove l'efficacia della piattaforma HyperThought potrà essere validata in scenari di produzione reale.
Potrebbero interessarti
Come scegliere un computer nel 2024
Nel 2024, l'acquisto di un computer è diventato un processo sempre più compl ...
Leggi ->Automatizza le tue strisce LED con Home Assistant: configurazione passo passo
Home Assistant è la piattaforma open‑source più diffusa per la domotic ...
Leggi ->Come gestire i log e i binlog di MySQL limitando la permanenza a 24 ore
La gestione dei log e dei binlog in MySQL è fondamentale per mantenere le prestaz ...
Leggi ->Nuove app Android per rilevare AirTag di terze parti: analisi delle migliori opzioni
Nuove app Android per rilevare AirT ...
Leggi ->Come creare un ambiente virtuale Python
Python è un linguaggio di programmazione versatile e potente, ampiamente utilizza ...
Leggi ->Batterie al Grafene
Il grafene è un materiale bidimensionale costituito da un singolo strato di atomi ...
Leggi ->